IEEE VIS2026 (TianJin)-Day 4
2026年11月13日,IEEE VIS 2026 天津分会场进入最后一天。当晚的连线先转播中国专场,随后是本届会议的 Capstone 报告与闭幕式。
中国专场
当晚连线的是中国专场 Let's dig into the data ,由香港科技大学(广州)杨维铠助理教授在天津会场主持,与 Boston 主会场同步直播。
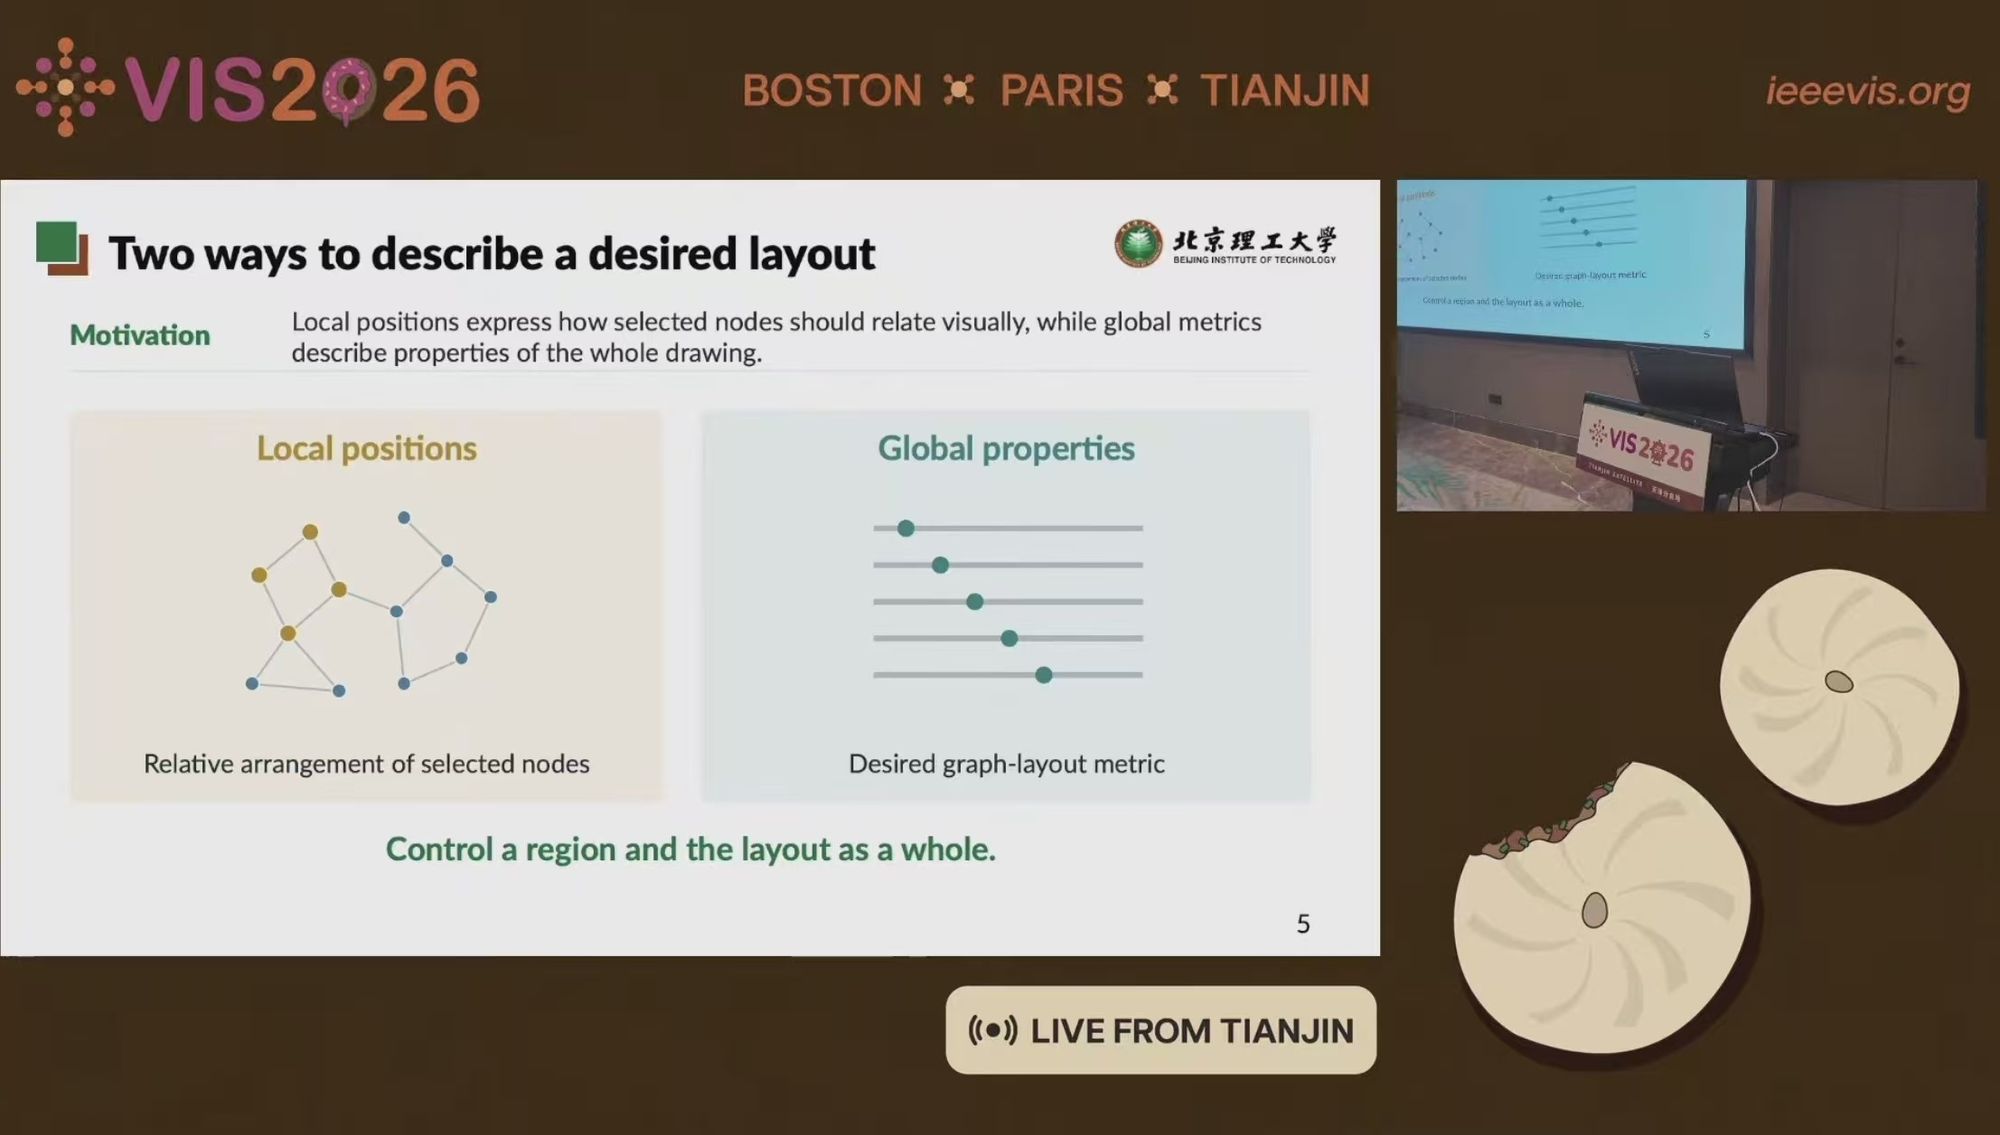
北京理工大学的《DiffGraph: Controllable Graph Layout Generation with Diffusion Models》认为,力导向布局要用户反复试调底层参数,深度学习方案又难以表达分析意图,因此该论文改用扩散模型按相对位置或整体指标生成布局。
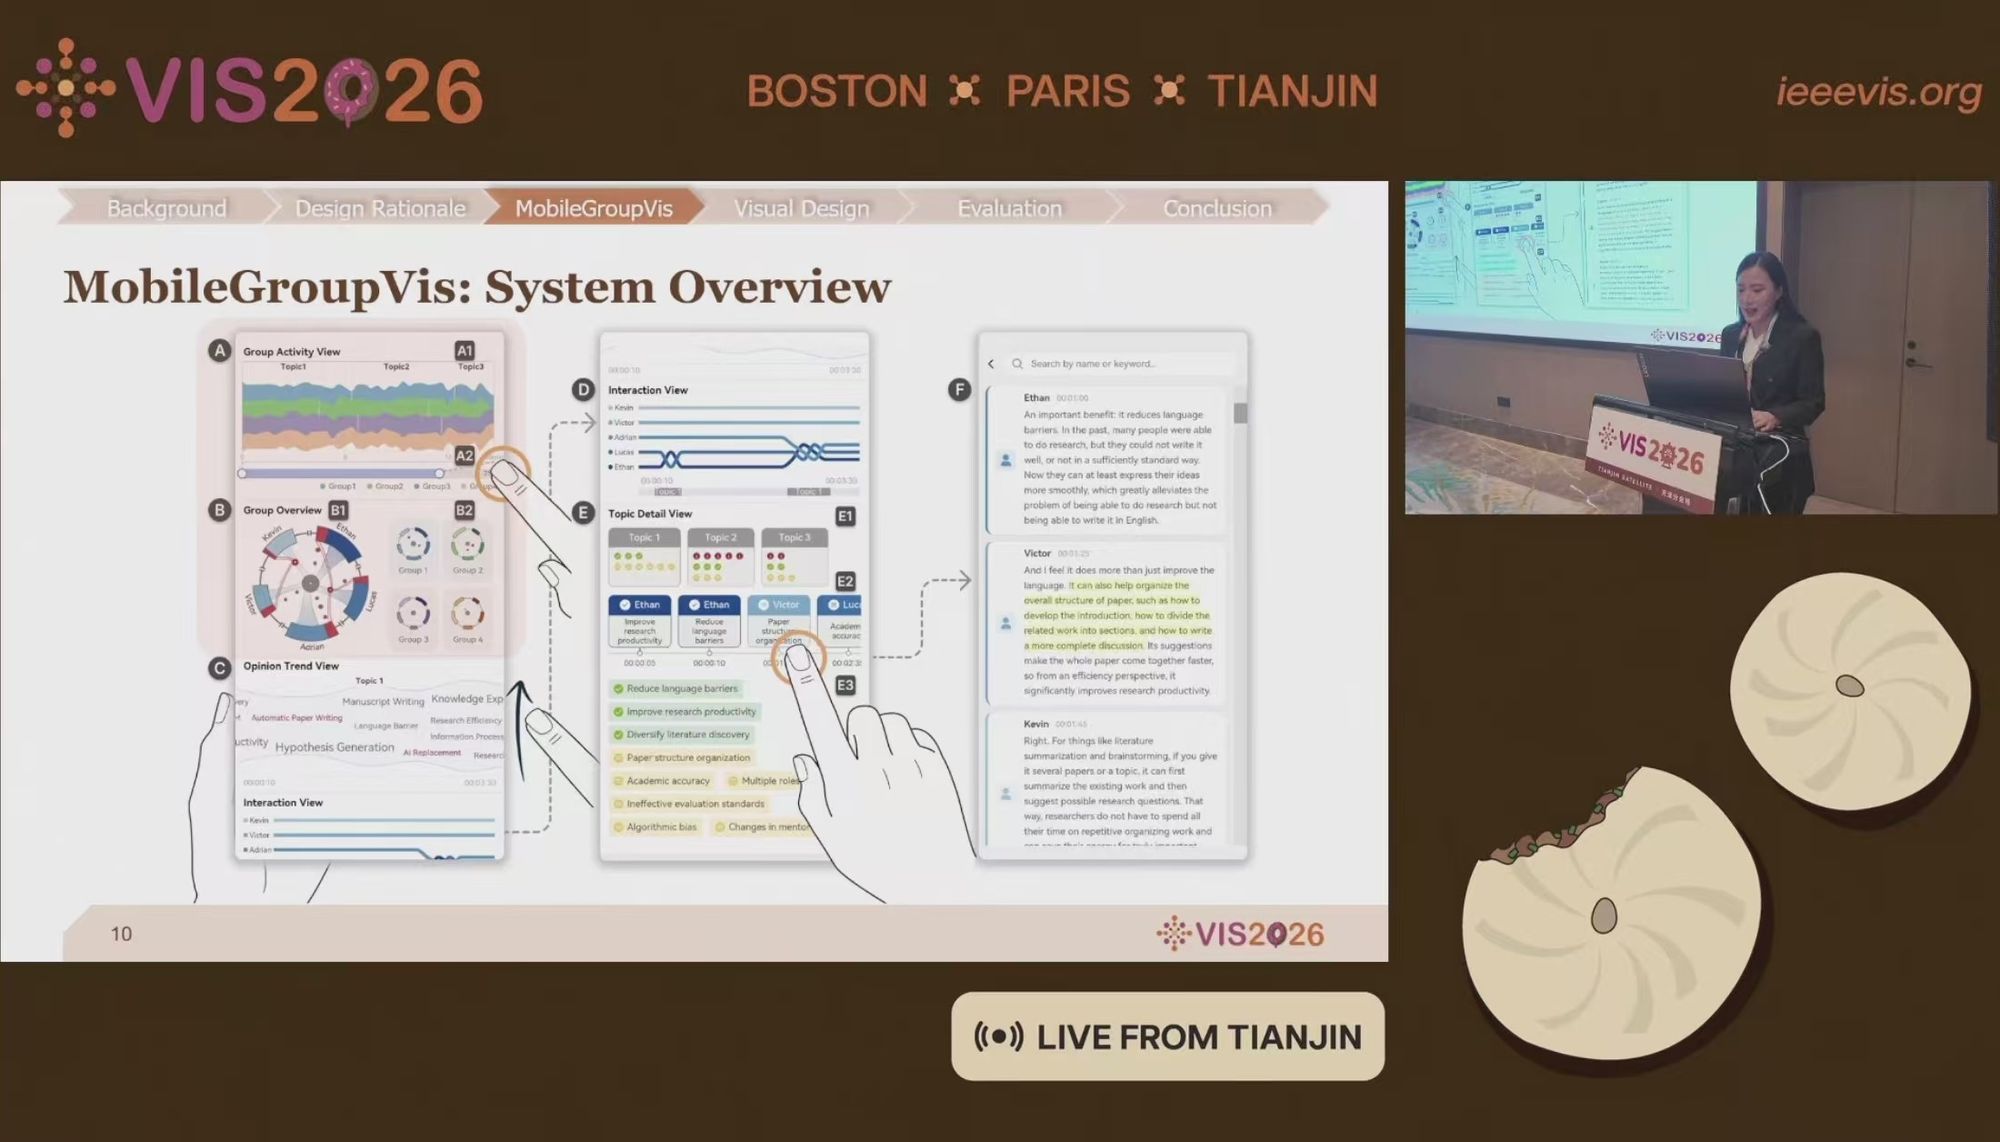
中南大学与香港科技大学(广州)合作的《Walking through Discussions: A Mobile Visual Analytics System for In-Situ Group Discussion Analysis》指出,课堂上的讨论分析不该只发生在课后的桌面上,教师需要边走边看,边判断哪个小组该介入,该系统用轻量流式管线把小组语音转成结构化讨论数据,以一个紧凑的小图形编码发言量、互动强度与话题偏离,便于跨组比较与异常定位。
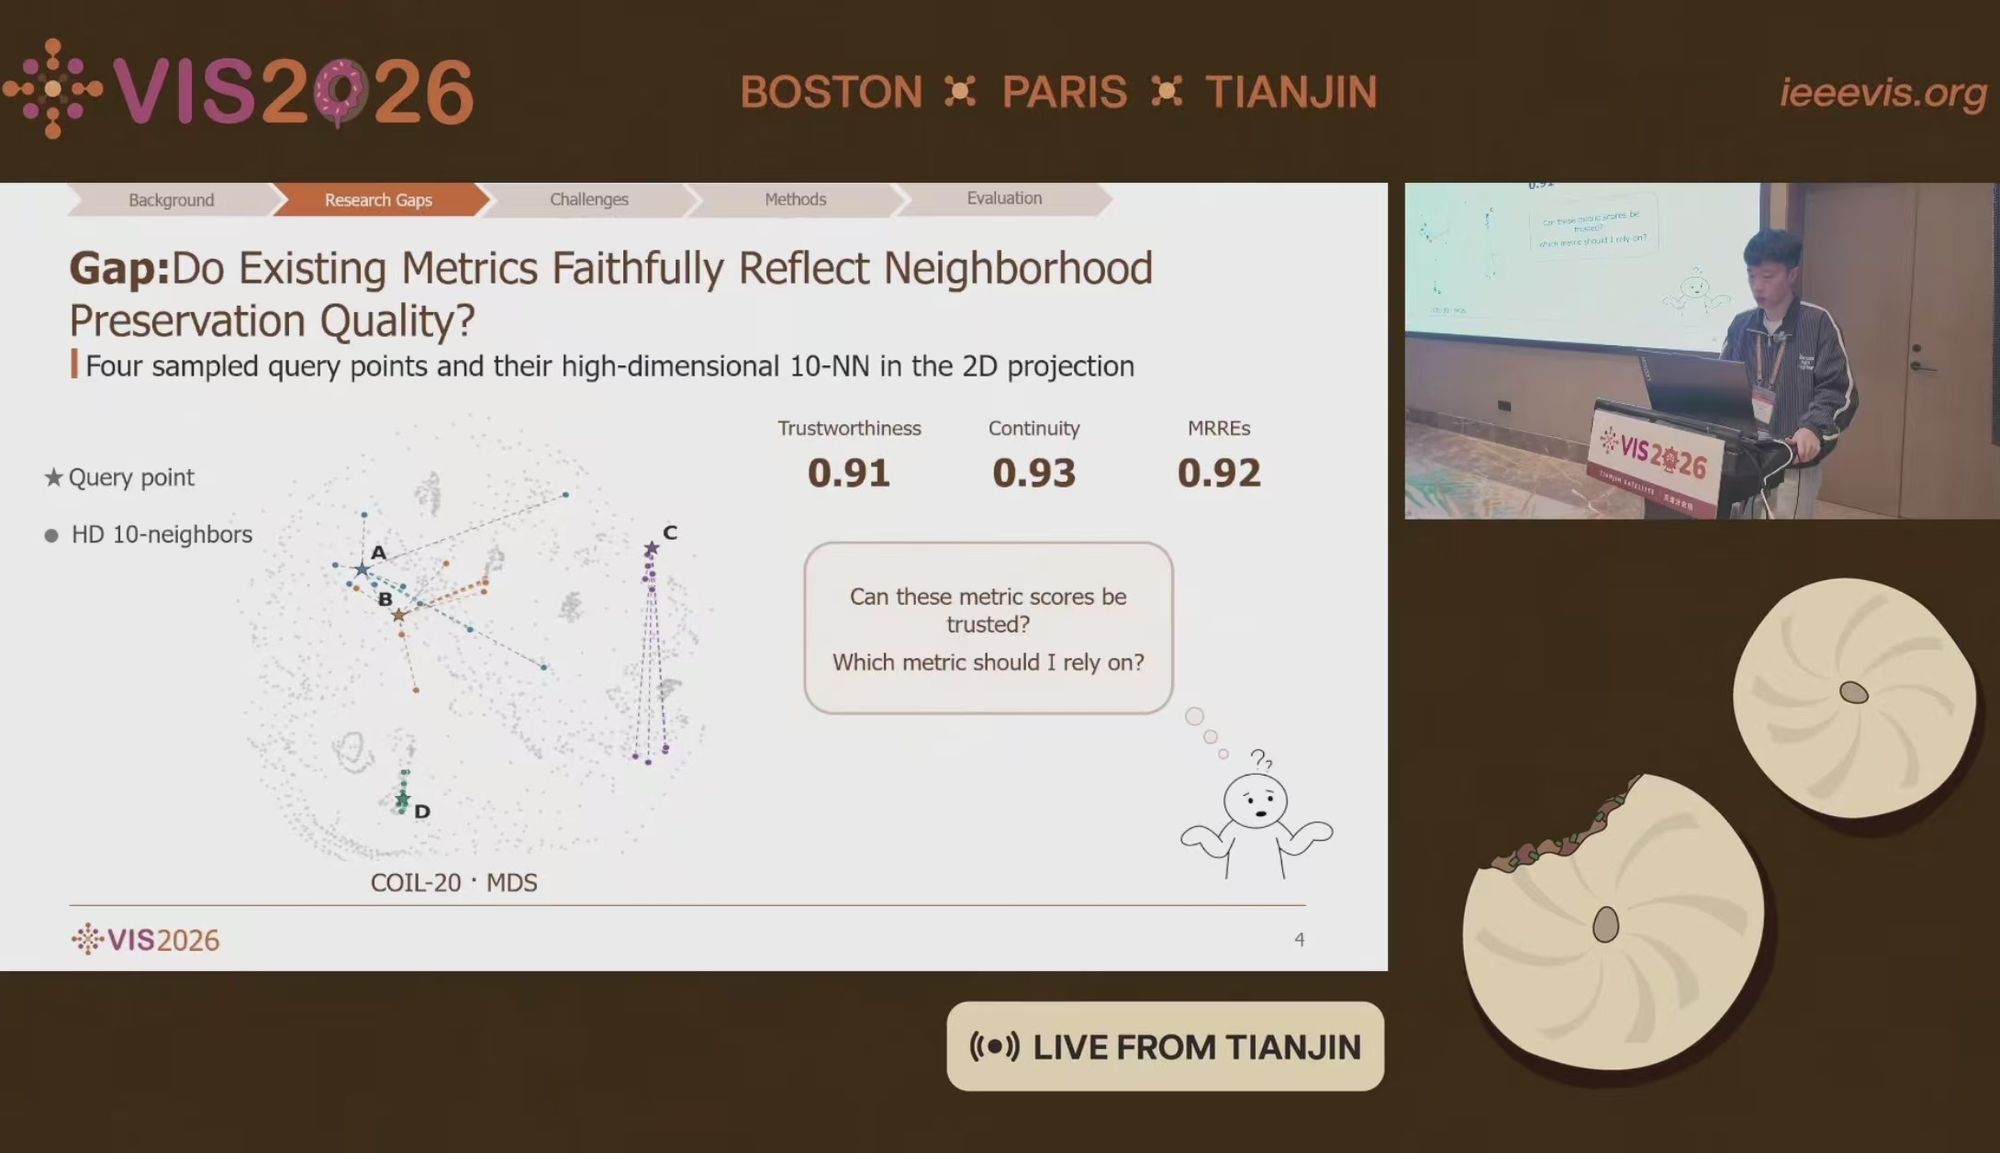
中南大学的《Beyond Quantification of Neighborhoods: Perception-Driven Quality Measures for Dimensionality Reduction》指出现有指标与人的视觉感知并不一致,有的投影邻域得分高过 0.99,高维近邻却在平面上被推到五倍邻域之外,该工作先建立邻域标注方案,再用成对比较压低标注量,训练网络模拟人的感知,并用这把新尺子复评了现有指标。
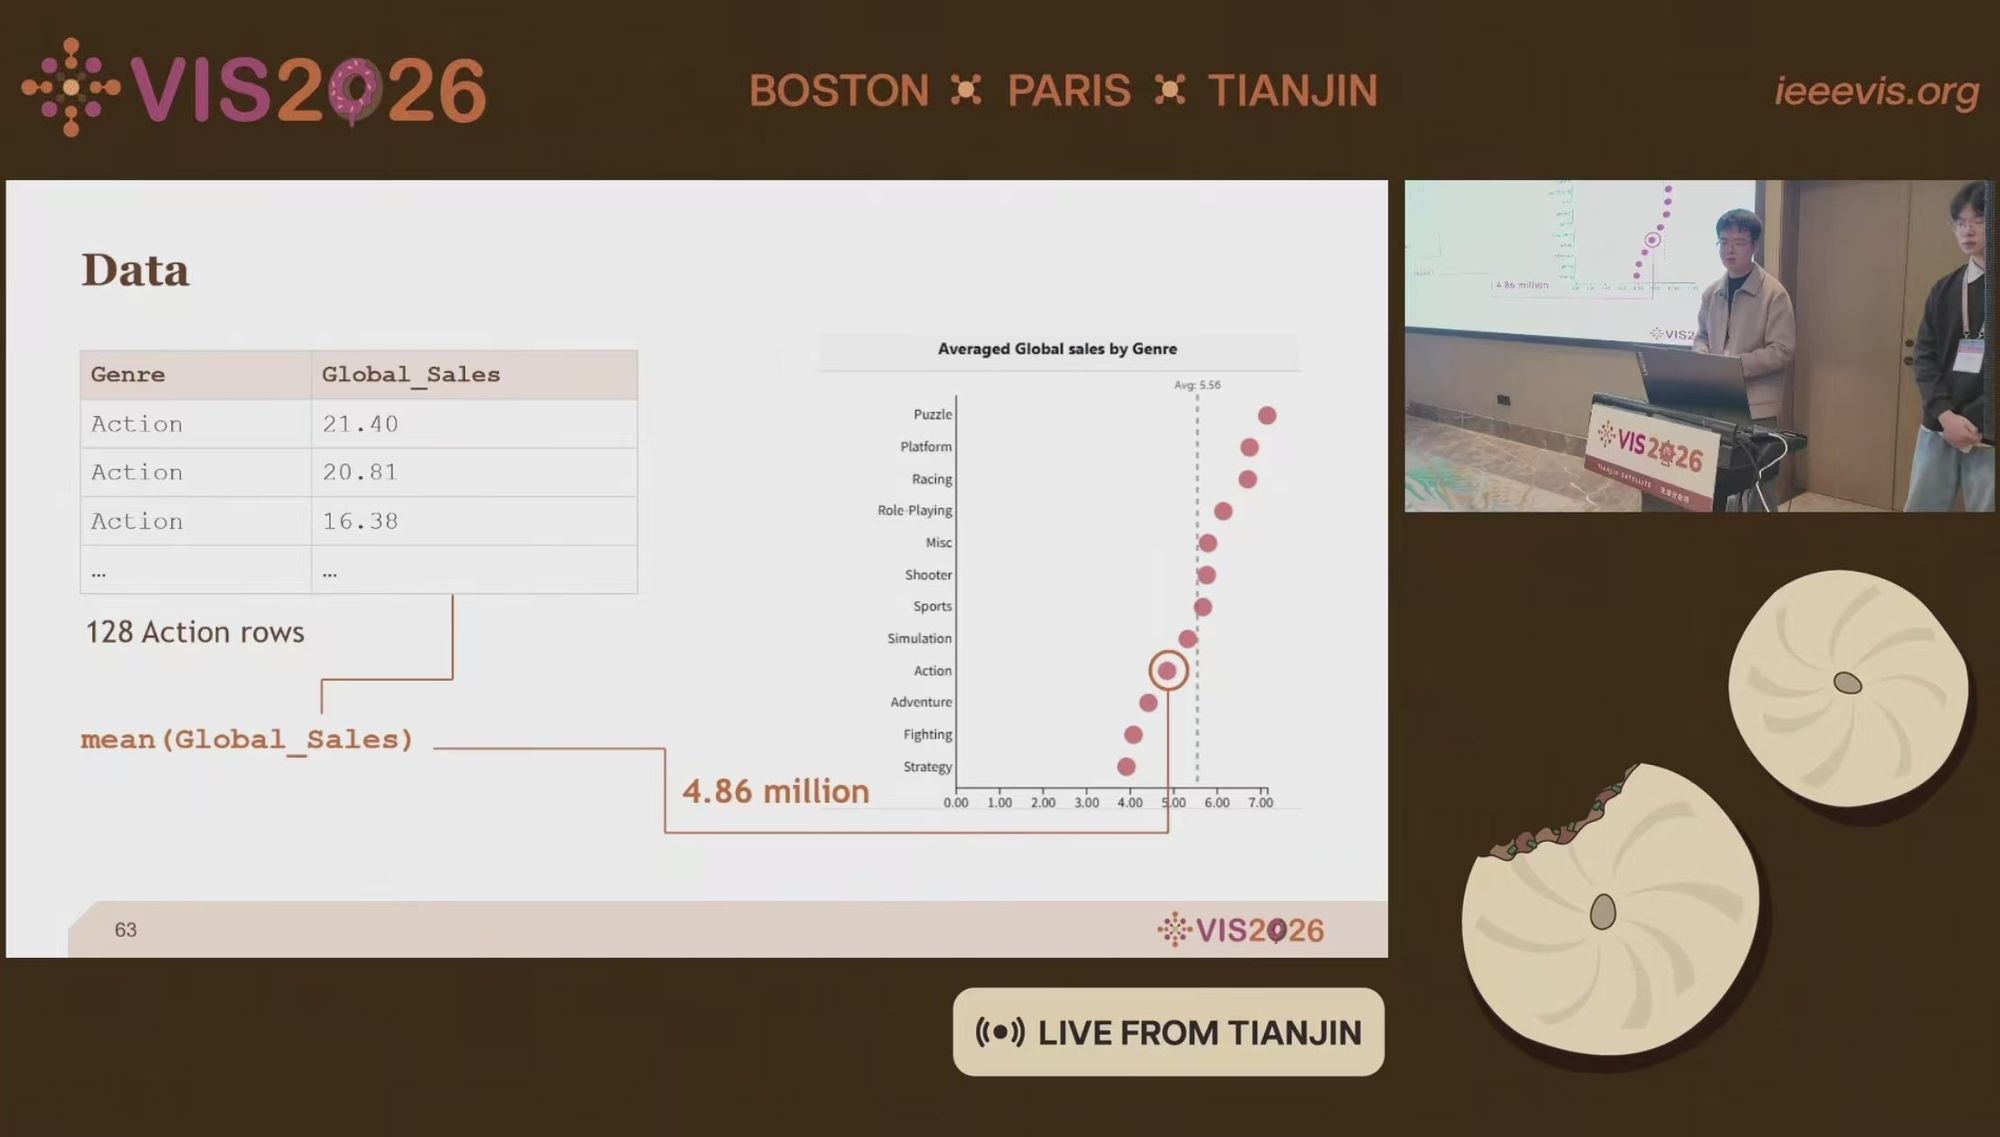
山东大学的《MV-Bench: Benchmarking Multimodal Large Language Models for Coordinated Multi-View Interface Construction》把评测对象从单张图表推进到协同多视图界面,以 Tableau 工作簿为真值来源构建出一千余个可执行实例。
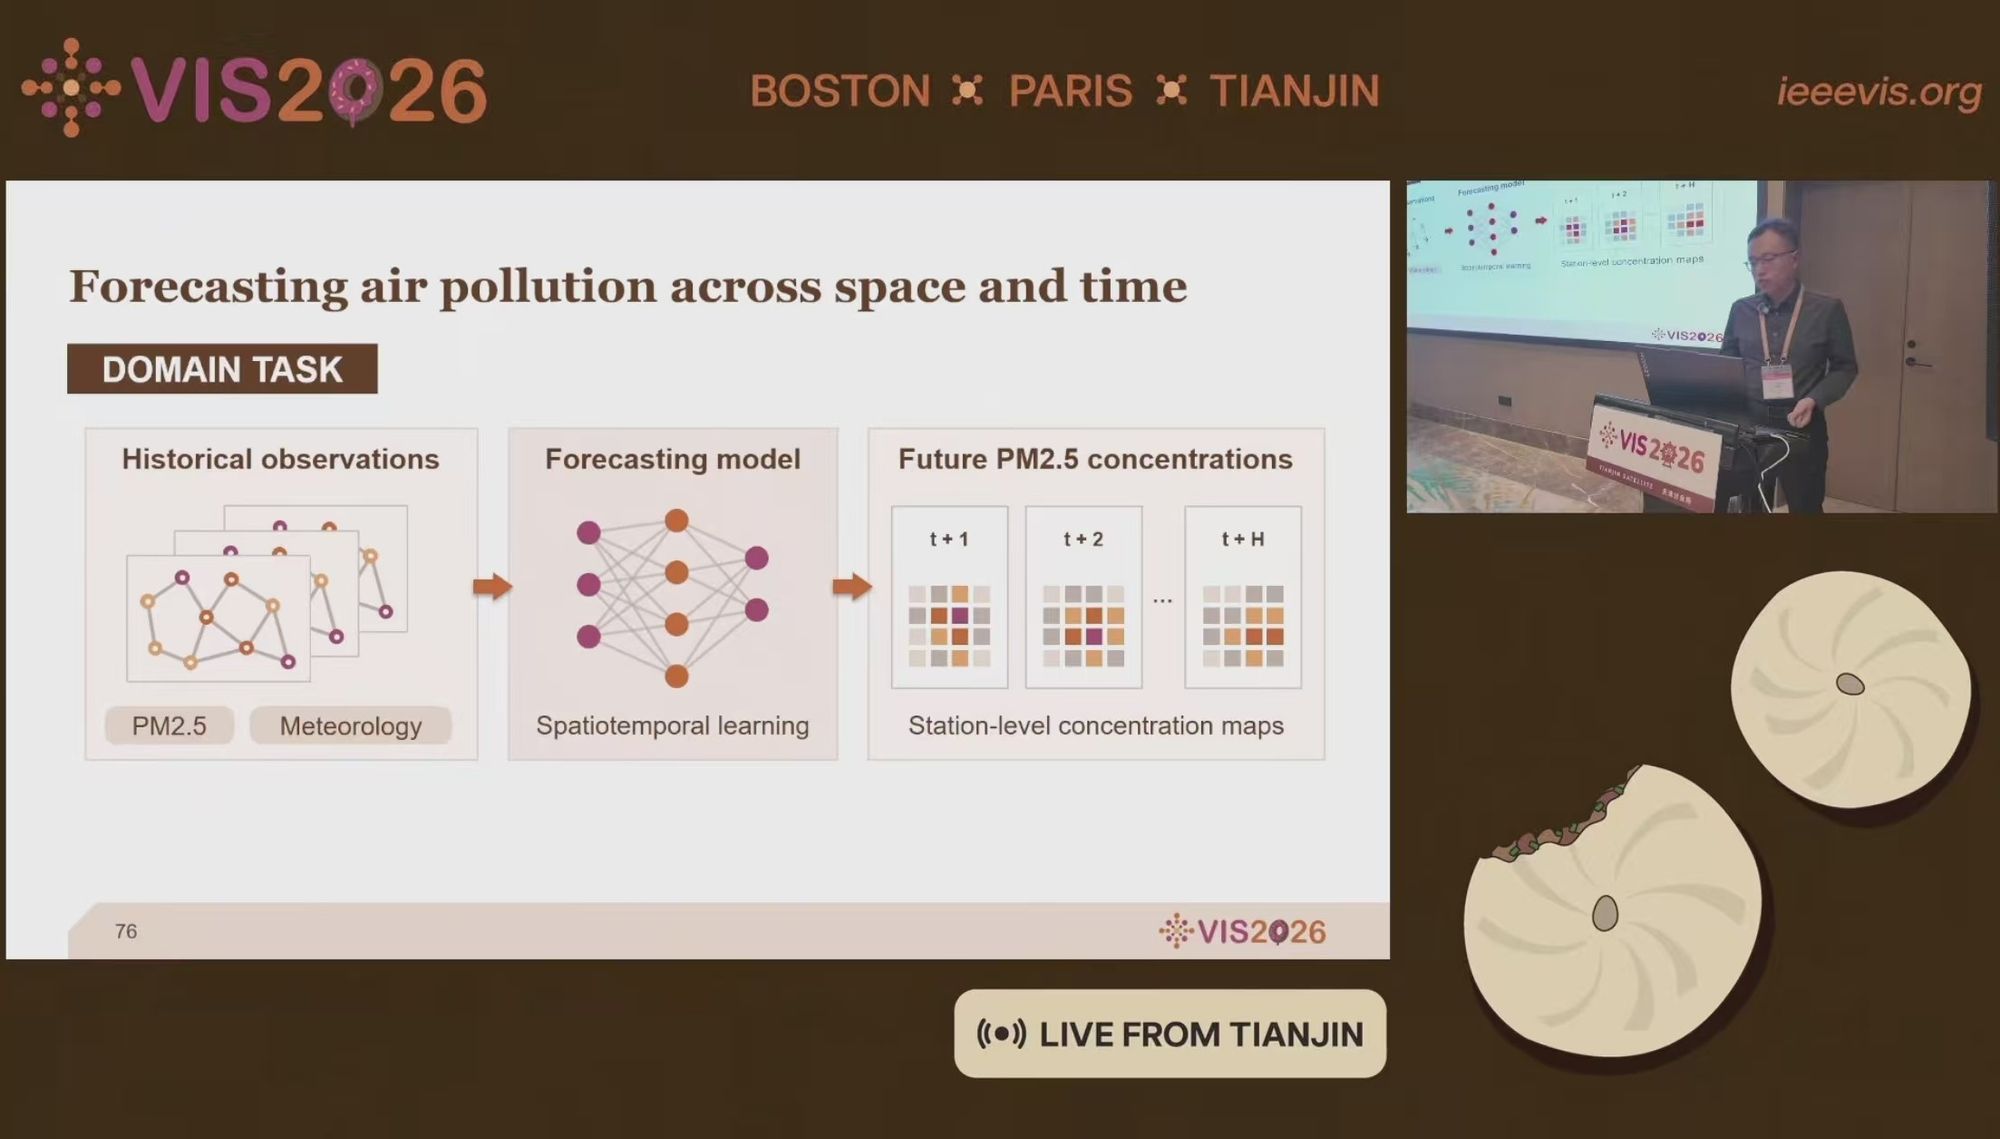
东北师范大学的《Probe-Driven Visual Analytics for Diagnosing and Enhancing Physical Knowledge in Air Quality Forecasting Models》探究了空气质量预报模型是否真的学到了物理知识,围绕平流与扩散两种输送机制设计探针任务,用选择性度量估计冻结隐层中物理知识的可恢复程度,把证据组织成从全局评估到情景定位、空间诊断与课程构建的渐进分析。
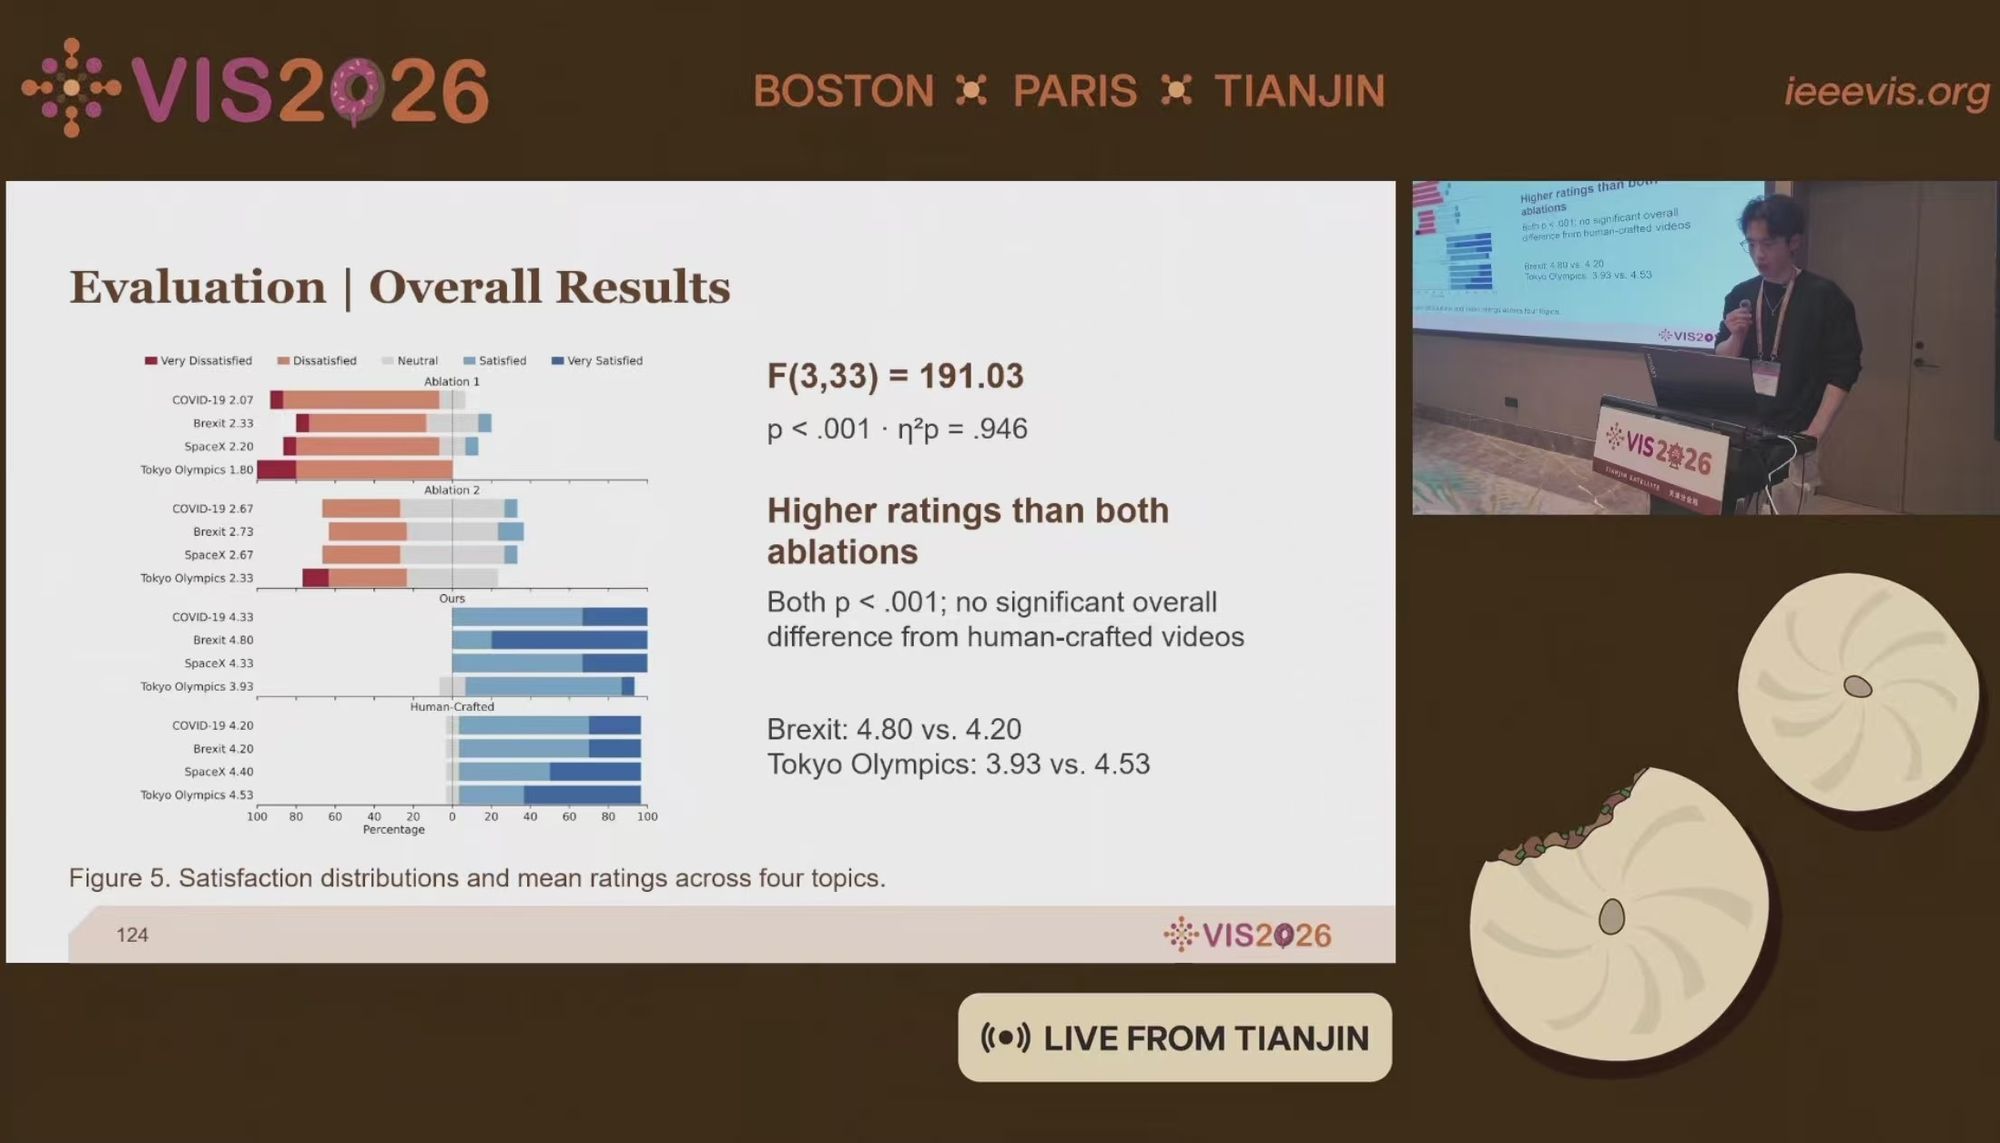
天津大学智能与计算学部的《EvoInsight: A Conversational Framework for End-to-End Generation of Topic-Oriented Videos from Large-Scale Texts》把主题演化从抽象而静态的输出转成动态的数据视频,用大模型在向量化知识库中发现主题、抽取事件并组织叙事主线,再以多智能体协作与图生图增强完成逐帧生成,使叙事流畅度与视觉一致性接近人工制作的视频。
Capstone 与闭幕
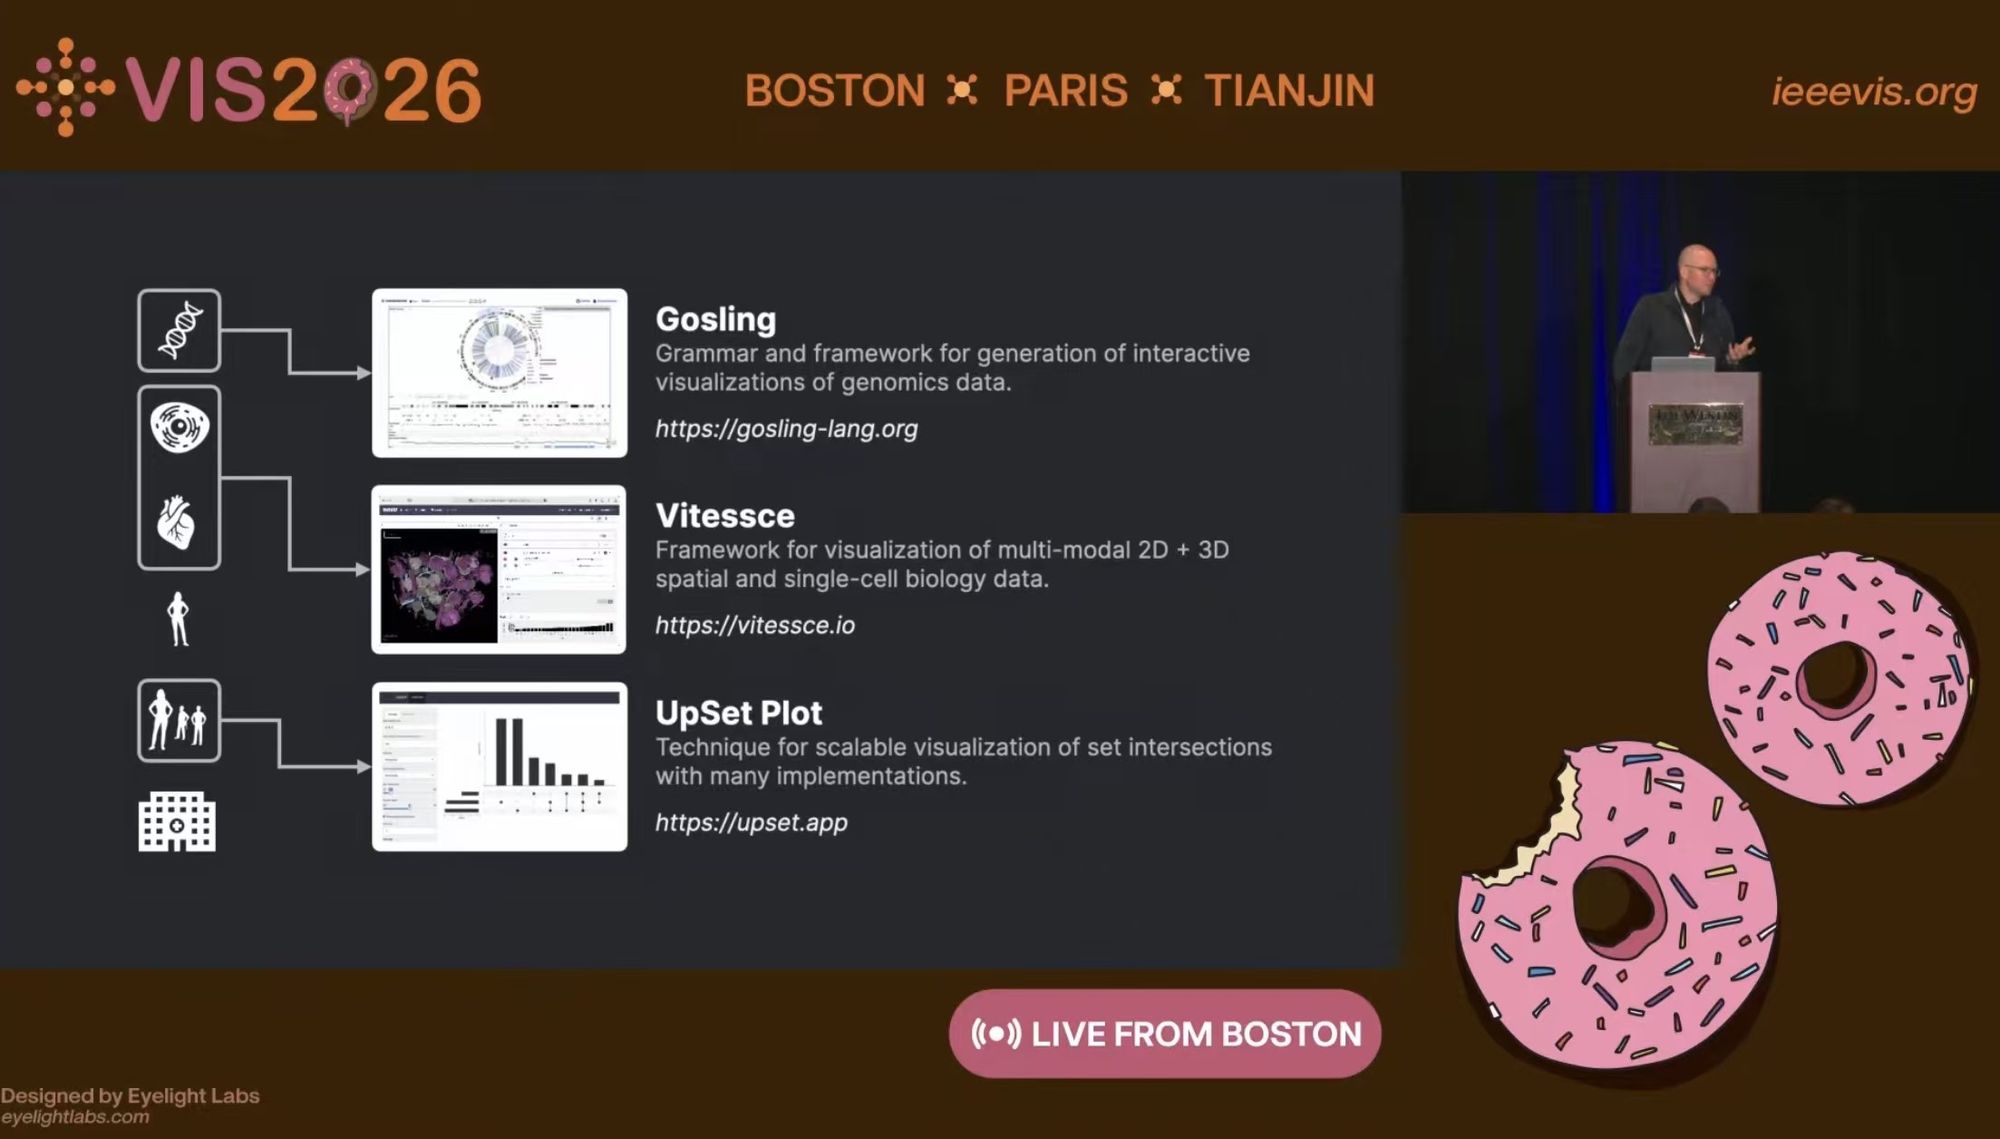
收尾的 Capstone 由哈佛医学院生物医学信息学系副教授 Nils Gehlenborg 带来,题目是 《The Eyes Still Have It: Do They?》,他的回答是数据已经多到没人看得完,但评估与引导 AI 的仍然是人。他以 Gosling、Vitessce 与 UpSet 说明可视化项目的成败很少只取决于方法与交互设计,重心正从探索数据转向理解证据、不确定性与 AI 系统的行为。
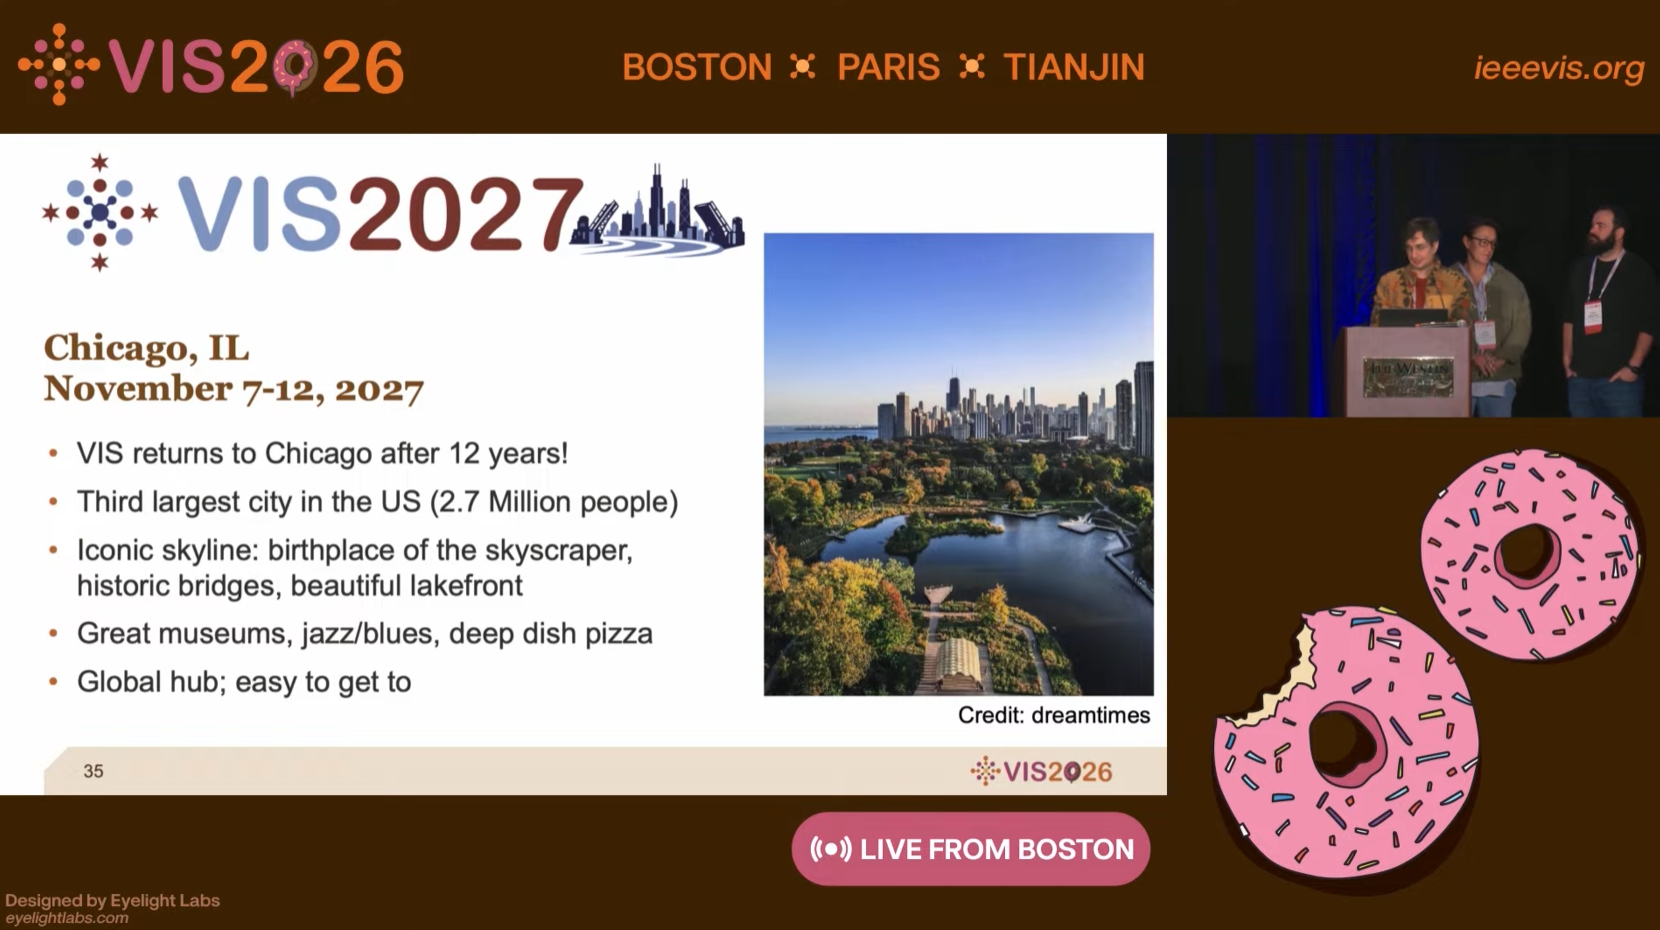
随后是本届会议的闭幕式,预告下一届会议将于 2027 年 11 月 7 日至 12 日在芝加哥举办,距上一次在芝加哥开会已过去十二年。天津分会场也至此收官,从学科战略研讨会、两场学科前沿讲习班、本地论文报告与 Poster,到每晚与 Boston 的连线,这是 VIS 历史上首次以卫星会场的形式完整走完一届会议。