时间:2026年10月10日(周六) 09: 00
地点:望江校区基础教学楼B座318实验室
分享者:杨鑫月、甘小容
Part1
分享者:杨鑫月
分享内容:
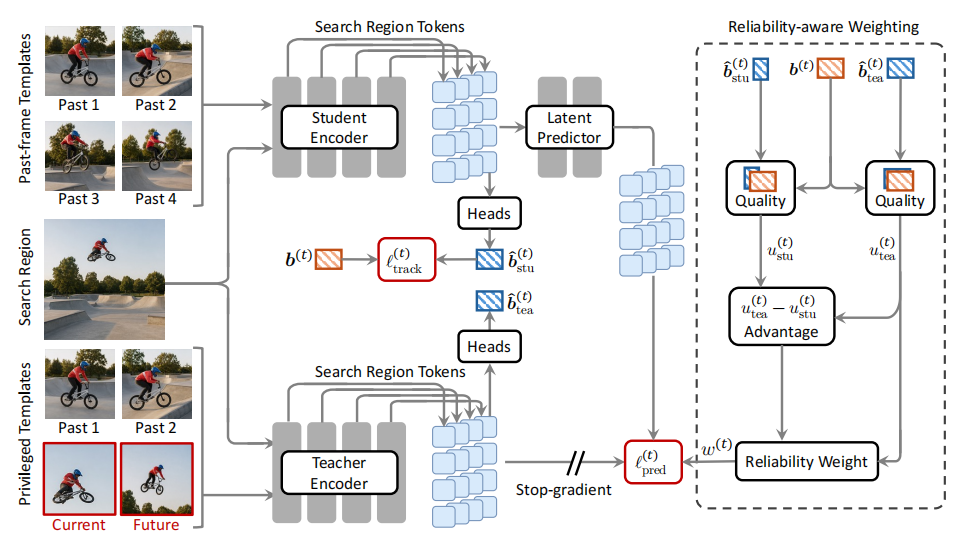
[1] X. Chen, J. Xu, D. Wang, H. Lu, and K. Ma, “Learning to Track from Privileged Target Appearances,” arXiv preprint arXiv:2609.02471, 2026.
论文简介:
视觉目标跟踪普遍面临推理时刻模板获取瓶颈:初始真值模板定位可靠但外观易老化,更新模板外观新鲜却来源于存在误差的模型预测,制约长时跟踪性能。特权信息学习可利用仅训练阶段能获取的监督信号提升模型,但如何有效迁移当前、未来帧真值目标外观仍缺少成熟方案。针对该问题,本研究围绕师生框架模板配置、表征蒸馏形式、样本可靠性筛选开展系统探究,提炼出特权外观迁移的实现方案,并据此提出Privileged Appearance Transfer for Tracking (PATT)跟踪训练框架。该框架通过特权教师获取当前与未来帧真值目标裁剪,采用多层级中间表征预测完成知识迁移,并引入可靠性权重过滤无效监督信号,训练结束后舍弃全部辅助模块,推理阶段不增加额外计算开销。在 7 个长短时跟踪基准上的实验表明,PATT在Base、Large两种模型规模下均可带来一致性能提升,跨数据集泛化表现优异,有效缩小普通跟踪器与 oracle 上界之间的性能差距。本研究为目标跟踪利用训练专属特权信息提供可行范式,也为时序视觉任务的训练策略优化提供新思路。
Part2
分享者:甘小容
分享内容:
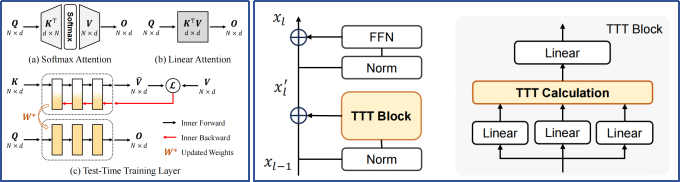
[1] Han D, Li Y, Li T, et al. ViT3: Unlocking Test-Time Training in Vision[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2026: 51-61.
论文简介:
视觉Transformer在图像理解与生成任务中表现出色,但其注意力机制的计算开销随序列长度呈平方增长,限制了高分辨率图像的高效处理。测试时训练(Test-Time Training,TTT)将注意力计算转化为在线学习过程,为实现兼具高效性与表达能力的视觉模型提供了新思路,但其内部模型结构与训练策略仍缺乏系统性的设计指导。针对这一问题,本研究围绕损失函数、学习率、批量大小、训练轮次以及内部模型的结构与容量开展系统实验,提炼出六项关键设计原则,并据此提出视觉测试时训练模型(Vision Test-Time Training,ViT³)。该模型通过针对当前输入的自监督学习,将视觉上下文信息压缩至内部模型参数中,并利用卷积结构融合全局信息与局部特征,实现了具有线性计算复杂度、支持并行计算的视觉序列建模。在图像分类、图像生成、目标检测与语义分割任务上的实验表明,ViT³能够达到甚至超越多种代表性的线性复杂度模型,并缩小与高度优化的视觉Transformer之间的性能差距。本研究为视觉测试时训练提供了实用设计依据,也为高效视觉模型的进一步发展奠定了基础。