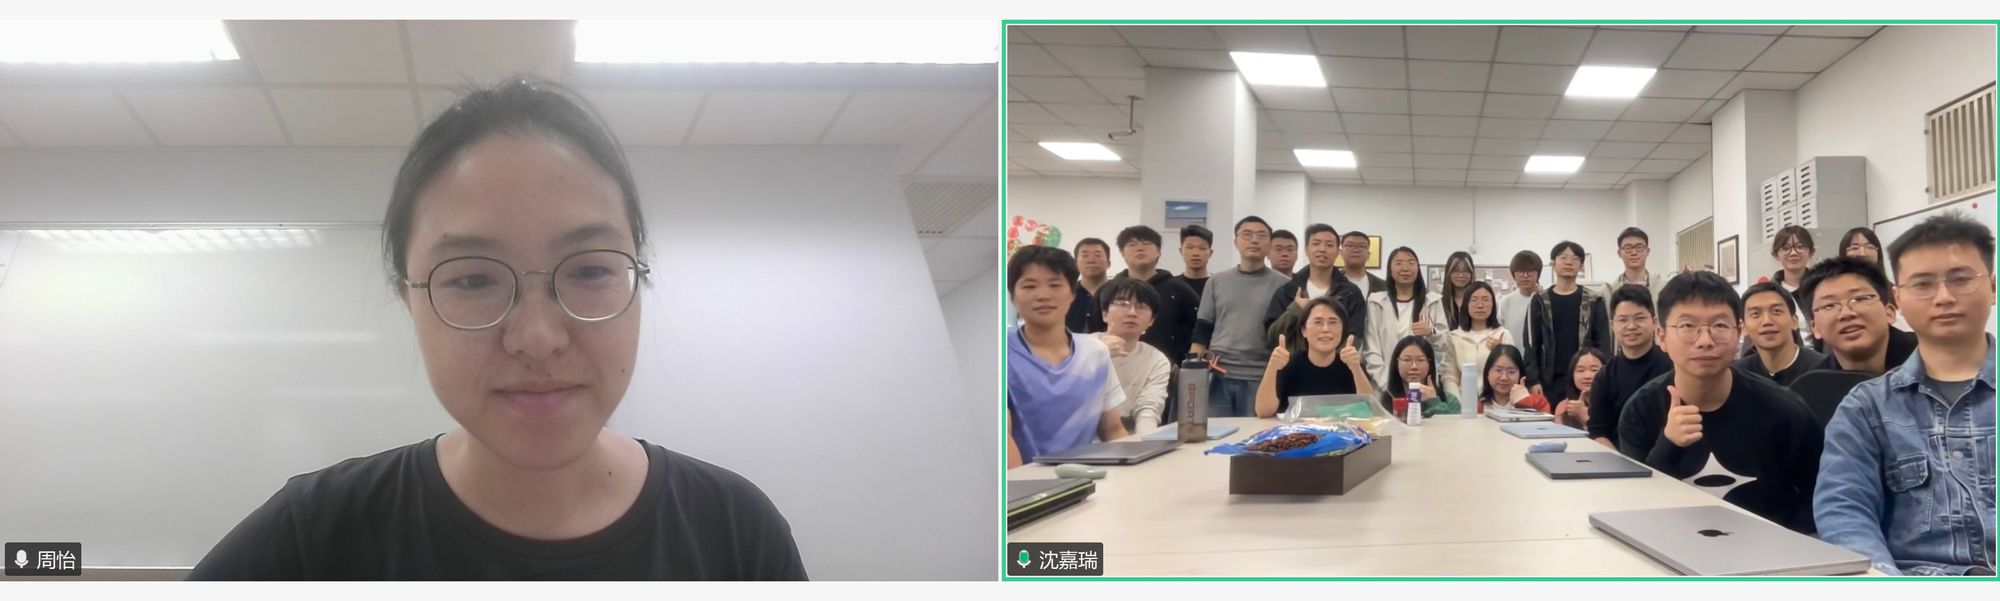
2026年11月7日上午,香港理工大学计算学系博士研究生周怡受邀在线上为视觉计算实验室带来题为“AI for Protein 研究与研究生经验分享”的学术报告。本次分享采用线上线下相结合的方式进行,由实验室负责人朱敏教授主持,实验室全体成员及部分本科生参与交流。
周怡于2024年获四川大学计算机科学与技术专业硕士学位,导师为朱敏教授,本科阶段受四川大学吴玉章荣誉学院培养,现于香港理工大学师从范文琦教授、李青教授攻读博士学位。她的研究方向聚焦AI for Science,尤其关注运用大语言模型与扩散模型解决蛋白质多模态建模问题,相关成果已发表于KDD、EMNLP、ICLR等会议。
分享环节,周怡首先系统梳理了蛋白质语言模型领域的研究版图。她从蛋白质“序列—结构—功能”范式出发,指出蛋白质数据兼具离散序列与连续几何结构的双重属性,而现有语言模型在处理连续结构信息时存在表征损耗。围绕这一核心问题,她重点介绍了三项工作:综述《A Survey on Protein Language Models》对蛋白质语言模型领域进行了体系化梳理;HD-Prot提出了一种混合扩散蛋白质语言模型,以连续结构token替代离散化token,在保持序列知识的同时显著降低了结构信息损失,该工作已被KDD 2026接收;MpLM Inference则从推理阶段切入,系统研究了多模态蛋白质语言模型在采样步数、温度退火与引导策略上的行为差异,揭示了推理协议对模型表现的关键影响,该工作被EMNLP 2026接收。
讨论环节气氛热烈。实验室2026级博士生、生物信息小组组长李天豪结合小组当前研究方向,就HD-Prot中连续结构token的编码方式、扩散过程与序列预测的耦合机制等技术细节与周怡进行了深入交流。其他成员也围绕蛋白质生成的可设计性评估、推理策略的迁移性等问题展开了讨论。
在科研经验分享部分,周怡结合自身经历,谈及对当前AI浪潮的观察与思考。她坦言,面对技术迭代的加速,研究者需要在“追赶热点”与“沉淀问题”之间保持清醒,并强调在“AI浪潮”下,“取得人的信任”更为重要。朱敏教授对此分享了自己的见解。她指出,研究方向的选择应当以真实问题为锚点,而非以工具或热点为起点;同时,她鼓励周怡在博士阶段保持与实验室的常态化学术联络,在蛋白质建模与生物信息学的交叉地带探索更多合作可能,也欢迎她常回实验室与师弟师妹交流。
本次交流在热烈的讨论中结束。周怡的报告不仅为实验室成员打开了AI for Protein这一前沿方向的技术视野,也提供了一个青年研究者审视自身科研节奏与成长路径的契机。